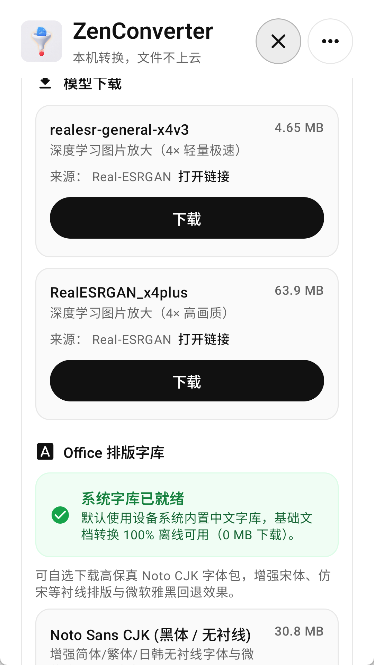
AI 模型需要按需下载 + GPU 依赖
两种 AI 功能,一套引擎
ZenConverter 的两条 AI 路线共用同一个推理引擎:Tencent NCNN,GPU 后端走 Vulkan。
| AI 功能 | 路线 | 模型大小 | 状态 |
|---|---|---|---|
| Real-ESRGAN 图片 4× 超分 | NCNN Vulkan | 4.65 MB(轻量)/ 63.9 MB(高画质) | Stable |
| RIFE 2× 视频补帧 | NCNN Vulkan | RIFE 模型 | Experimental |
两条路线都是 Android 专属——需要 arm64-v8a 架构 + Vulkan GPU 支持。不满足其中任何一条,AI 功能就不会出现或会明确报错。
为什么模型不打包进 APK
APK 现在约 38.8 MB。如果把 AI 模型(至少一个 4.65 MB + 63.9 MB 两个)都打包进去:
- APK 会变成约 107 MB;
- AI 功能不是刚需——很多用户只用格式转换,不会碰 AI 超分/补帧;
- 模型可能更新,打包进 APK 后更新模型必须更新整个应用。
所以 ZenConverter 选择按需下载:想用 AI 功能时才下载模型,下载后用 SHA-256 校验确认和官方仓库的哈希一致。
SHA-256 校验的意义
SHA-256 校验是为了防止两种风险:
- 下载损坏:网络不稳定时下载到一半文件不完整;
- 模型替换:如果模型下载来源被劫持(比如不安全的网络环境),攻击者可能替换模型文件。
校验失败 → 模型不会被加载,ZenConverter 会提示"校验失败,请重试"。这不是网络不好的问题,而是文件完整性有问题。
GPU 加速 vs CPU Fallback
| 路径 | 条件 | 速度 |
|---|---|---|
| Vulkan GPU 加速 | 设备 GPU 支持 Vulkan + NCNN Vulkan 库正常 | 快(图片超分几秒到几十秒) |
| CPU Fallback | 设备不支持 Vulkan,或 Vulkan 初始化失败 | 慢(图片超分可能几分钟) |
ZenConverter 优先走 Vulkan GPU 加速。如果设备不支持,不会直接失败——会 fallback 到纯 CPU 推理,速度慢但功能可用。
RIFE 视频补帧(Experimental)和 Vulkan GPU 的耦合更紧,某些 RIFE 失败场景可能没有有效的 CPU fallback。
arm64-v8a Only 的影响
AI 引擎(libzen_ncnn.so + libncnn.so)只编译了 arm64-v8a ABI。32 位 ARM 设备:
- 整个 APK 装不上(APK 只含 arm64 native 库);
- 不是只 AI 功能不行,是整个 ZenConverter 都用不了。
这和 FFmpeg、office2pdf、woff2 native 库的 arm64-only 情况一致。
实验性路线的风险
RIFE 视频补帧标为 Experimental,原因是:
- 移动端芯片的 GPU Vulkan 驱动差异巨大——某些骁龙、联发科、麒麟芯片的 Vulkan 驱动可能让 NCNN 初始化失败;
- 显存调度差异——某些设备的 GPU 显存管理策略会导致推理中途被系统杀掉;
- 模型加载和推理的内存峰值不稳定——不同场景波动大。
Experimental 状态意味着"能用但不稳定",不是"不能用"。
使用建议
| 场景 | 推荐 |
|---|---|
| 图片放大(不是特别急) | 先下轻量模型(4.65 MB),够用 |
| 图片放大(追求画质) | 下高画质模型(63.9 MB),画质更好 |
| 视频补帧(想试一下) | 先确认设备支持 Vulkan,跑一次试试 |
| 视频补帧(想长期用) | 先在一台稳定的设备上验证,不要在重要任务上第一次用 |
已知边界
- 模型下载来源:从 GitHub Releases 下载,不走自建 CDN;
- 网络环境:下载模型需要能访问 GitHub(中国大陆用户可能需要代理);
- 模型管理:下载的模型会被缓存到应用私有目录(卸载会被清掉);
- 不是万能超分:某些艺术风格的图用 Real-ESRGAN 反而会被过度锐化,不如双线性插值路线。
相关页面
- Real-ESRGAN 深度学习 4× AI 超分 —— 两条模型的详细对比
- AI 补帧:RIFE 2× 与光流 minterpolate —— 视频 AI 路线
- 双线性插值 2×/3×/4× —— 零依赖、不走 NCNN 的替代路线